Видео · сценарий и звук · обновлено 20 октября 2026 г. · 10 минут
Генерация видео со звуком по API: от сценария до проверки синхронизации
Чтобы AI-видео звучало понятно, одного generate_audio: true недостаточно. Нужно решить, какой звук главный, когда он возникает и что должно остаться тихим. Разберём пятисекундную сцену с велосипедом: от раскадровки до запроса и приёмки MP4.
Решите, что зритель должен услышать
Для короткого ролика начните с одного слышимого события. В нашем учебном примере велосипед стоит у парковой дорожки, рука нажимает звонок, после звона остаётся спокойный фон. Главный звук — велосипедный звонок. Второстепенный — лёгкий ветер в листве. Речи, музыки и шума машин не требуется.
Такое описание задаёт приоритеты. Если одновременно попросить бодрую музыку, несколько разговоров и громкий звонок, модель может заполнить сцену звуком, но зрителю станет труднее понять событие. Чёткая иерархия полезна и для запроса, и для последующей оценки: слышно ли главное действие и не мешает ли ему фон.
Этот материал посвящён режиссуре новой сцены с нативным аудио. Для уже снятого немого видео есть отдельный путь добавления звука. Для точной реплики диктора и движения губ нужны другие критерии, чем для звона или ветра. Выбирайте процесс по задаче, а не только по наличию аудиопереключателя.
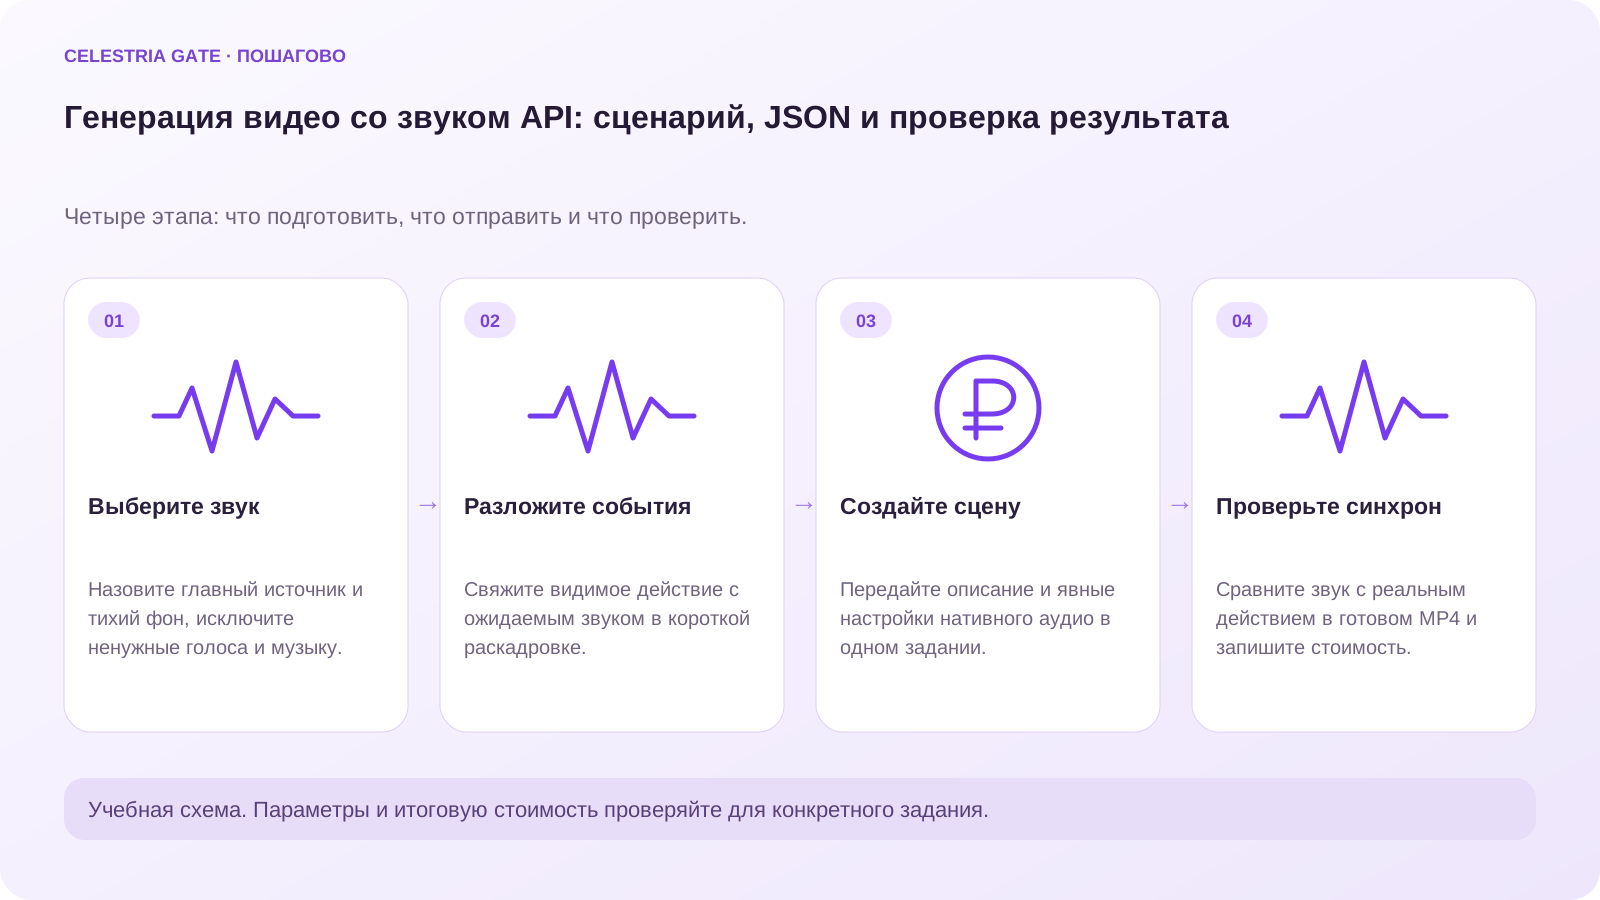
- Выберите звук: Назовите главный источник и тихий фон, исключите ненужные голоса и музыку.
- Разложите события: Свяжите видимое действие с ожидаемым звуком в короткой раскадровке.
- Создайте сцену: Передайте описание и явные настройки совместного аудио в одном задании.
- Проверьте синхрон: Сравните звук с реальным действием в готовом MP4 и запишите стоимость.
Разложите пять секунд на три события
Перед API составьте маленькую таблицу. В ней достаточно времени, изображения и ожидаемого звука. Тайминги в описании — пожелания к генерации, а не гарантия покадрового исполнения. Если финальный файл чуть иначе располагает действие во времени, оценивать звук нужно относительно реального касания в кадре.
Не обязательно перечислять каждую долю секунды. Слишком плотный сценарий повышает вероятность, что модель пропустит часть событий. Для первого дубля оставьте один непрерывный план и один источник основного звука. Монтаж из нескольких локаций лучше проверять после того, как простой случай работает.
| Фрагмент | Изображение | Аудио | Что проверим |
|---|---|---|---|
| Начало, 0–1 с | Велосипед неподвижен, видна ручка звонка | Тихий ветер и парк | Нет лишней речи и музыки |
| Середина, 1–3 с | Палец нажимает рычаг звонка | Один отчётливый металлический звон | Звук связан с нажатием |
| Конец, 3–5 с | Рука уходит, велосипед остаётся | Затухание и спокойный фон | Нет второго необъяснимого звонка |
Выберите создание звука вместе с видео
Модель со звуком получает описание визуальной и звуковой частей в одном запросе. Для примера используем Seedance 1.5 Pro: model=bytedance/seedance-1-5-pro и operation=text-to-video. В общем API Gate duration задаётся числом, generate_audio — логическим значением. Отдельную звуковую дорожку на вход мы не передаём.
Альтернативой может быть поддерживаемая операция Wan со звуком. Авторизация и API-пути остаются теми же, но допустимые значения и дополнительные параметры у моделей различаются. Нельзя поменять только ID и считать любые настройки поддержанными. Gate адаптирует подтверждённые поля, а неподдерживаемую комбинацию нужно исправить до запуска.
Загрузите /v1/media/models/schema для выбранных model и operation. Затем проверьте карточку из GET /v1/media/models: её data[].id и native_generation сообщают о доступности и причинах неготовности. pricing_verification_required означает, что запуск ещё требует подтверждённого тарифа. Одна карточка семейства не обещает готовности каждой операции.
Опишите звук как действие, а не как настроение
Полезный порядок промпта: место, предмет, действие, камера, главный звук, фон и нежелательные элементы. Для звонка важно упомянуть момент нажатия. Формулировка «реалистичный звук» слишком общая: она не указывает, должен ли в кадре быть один звон или целая музыкальная композиция.
Англоязычный пример ниже можно использовать как исходную структуру. Мы не утверждаем, что он уже дал удачный ролик. Если требуется русская речь, заранее добавьте точный текст и отдельно проверяйте язык и произношение выбранной модели. Для этого учебного запроса диалога нет, поэтому речевые возможности не входят в критерии приёмки.
{
  "model": "bytedance/seedance-1-5-pro",
  "input": {
    "operation": "text-to-video",
    "prompt": "One continuous locked-off close shot of a parked bicycle handlebar in a quiet leafy park. A hand enters, presses the bicycle bell once, then leaves. A single clear metallic bicycle bell ring exactly when the lever is pressed, with a natural short decay. Very soft wind in leaves in the background. No dialogue, no music, no traffic, no subtitles.",
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "16:9",
    "generate_audio": true,
    "parameters": {
      "camera_fixed": true,
      "enable_safety_checker": true
    }
  }
}Передайте сценарий и сохраните ID
Сохраните JSON в bell-scene.json и используйте ключ Celestria Gate. Запрос отправляется в /v1/media/generations. Внутри input заданы общие параметры, а camera_fixed и enable_safety_checker находятся в parameters. Gate выбирает совместимый провайдерский маршрут; при единственном маршруте он не объявляет победу в сравнении цен.
Отправьте запрос один раз. Idempotency-Key обозначает конкретную попытку: при обрыве сети повторяйте тот же JSON с тем же ключом. После ответа 202 сохраните id задания. Успешный HTTP-ответ создания означает принятую задачу, а не уже проверенный звук.
curl --fail-with-body -X POST \
  'https://api.celestriagate.com/v1/media/generations' \
  -H "Authorization: Bearer $CELESTRIA_API_KEY" \
  -H 'Content-Type: application/json' \
  -H 'Idempotency-Key: bicycle-bell-scene-001' \
  --data-binary @bell-scene.json
Проверьте звук относительно видимого события
После completed откройте result.video.url или видео из files. Сначала просмотрите весь файл без пауз, затем найдите момент нажатия. Звон, который возникает заметно раньше пальца, не проходит выбранный критерий, даже если сам по себе звучит правдоподобно. То же относится к повторному звуку без второго действия.
Послушайте результат в наушниках и через обычный динамик. Проверьте начало и конец: нет ли щелчка на границе файла, внезапного обрыва затухания или неожиданной тишины. Затем сравните громкость фона и главного события. Тихий ветер должен поддерживать сцену, а не скрывать звон.
Если нужна точная синхронизация для рекламы, отметьте время видимого события и соответствующего звукового пика в редакторе. Даже без сложных измерений такая запись помогает объяснить причину отказа от дубля. Формулируйте замечание конкретно: «звон раньше касания», а не «аудио какое-то странное».
| Критерий | Признак пригодного результата |
|---|---|
| Причина | Звон соответствует нажатию рычага |
| Количество | Один звон для одного действия |
| Приоритет | Главное событие слышнее фоновой атмосферы |
| Содержимое | Нет случайных слов, транспорта и музыки |
| Границы | Начало и затухание не обрываются резко |
Сравните цену дубля и цену принятой сцены
По опубликованному тарифу fal на 20 октября пять секунд Seedance 1.5 Pro 720p со звуком стоят примерно $0,26. Ориентир Gate по расчётному коэффициенту 110,63 ₽ за $1 — около 29 ₽. Это предварительная оценка; окончательные суммы конкретного задания берутся из billing после completed.
Если готовое изображение уже устраивает, отдельная генерация атмосферы может быть дешевле полного повторения сцены. MMAudio V2 имеет опубликованную ставку $0,001 за секунду. Но отдельный аудиопроход не доказывает тот же результат, что совместная генерация, особенно для речи и сложных взаимодействий.
Запишите причину каждой новой попытки. Изменить только громкость вручную иногда проще, чем заново генерировать удачное движение. Если меняете промпт и делаете новый POST, это отдельная платная генерация. Общий бюджет должен включать все завершённые оплаченные дубли, а не только тот, который показан клиенту.
Что передать разработчику и клиенту
Для разработчика сохраните JSON без ключа, модель, ID задания, ссылку на исходный результат и фактическую стоимость. Для клиента достаточно ролика, короткого описания задачи и понятного вывода по критериям: что получилось и что требует правки. Творческое пожелание, схема API и реально полученный результат должны быть различимы.
Если задание находится в awaiting_billing, продолжайте проверять тот же ID. При failed прочитайте error.code и error.message до новой попытки. Не делайте вывод о качестве звука по технической ошибке: модель могла вообще не завершить обработку. Такой порядок сохраняет и ясность отчёта, и бюджет повторов.
Частые вопросы
Почему generate_audio: true недостаточно для хорошего звука?
Параметр включает генерацию, но не задаёт главный источник, фон, количество событий и критерии синхронизации. Их нужно описать в сценарии и проверить в результате.
Как проверить совпадение звука с действием?
Найдите реальный момент события в готовом файле и сравните его с началом соответствующего звука. Для строгой приёмки запишите оба времени в редакторе.
Можно ли в одном коротком видео заказать диалог, музыку и эффекты?
Возможность зависит от модели. Для первого теста проще одна сцена и один главный звук; сложный микс требует отдельной проверки разборчивости и синхронизации.
Можно ли исправить только звук готового видео?
Можно рассмотреть отдельный аудиопроход, например MMAudio, либо монтаж. Это отдельная операция; она не является повторным созданием всего ролика и не гарантирует точную речь.