Видео · звук и интеграция · обновлено 20 октября 2026 г. · 16 минут
Видео со звуком через API: генерация сцены и озвучивание готового ролика
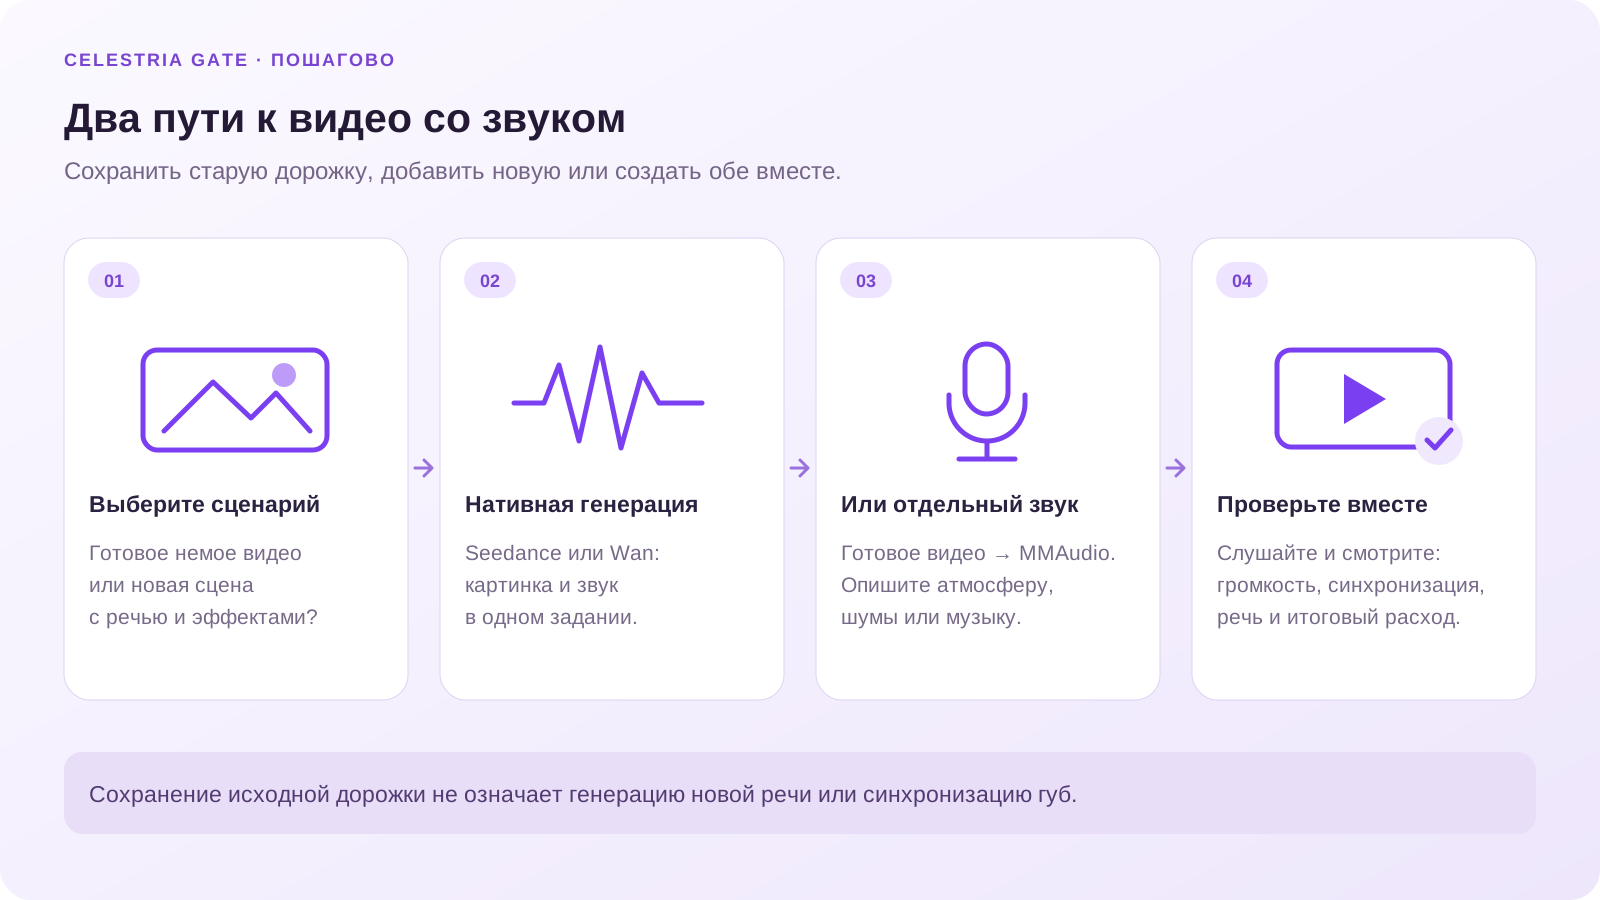
Можно создать изображение и звук одним запросом, а можно добавить атмосферу к уже готовому видео. Покажем оба пути: какие модели выбрать, что написать в запросе, как дождаться MP4 и где увидеть окончательную стоимость. Примеры используют ключ Celestria Gate; отдельный ключ fal клиенту не нужен.
Какой звук нужен вашему видео
Слово «звук» скрывает несколько задач. Сохранить дорожку исходного видео, придумать шум дождя, произнести заданную фразу и синхронизировать губы — разные операции. Начните с результата, который хотите услышать. Для пейзажа достаточно атмосферы. Для разговора нужны понятные слова, подходящий голос и совпадение речи с изображением.
Если ролика ещё нет, модель с нативным аудио может создать сцену и звук одновременно. Если изображение уже нравится, отдельный аудиопроход позволяет работать со звуковым сопровождением, не заказывая заново весь визуальный сюжет. Но возможность добавить шумы сама по себе не подтверждает качественную речь или точную синхронизацию губ.
| Что вы хотите | Подходящий путь | Что проверять |
|---|---|---|
| Новая сцена с шумами, музыкой или диалогом | Модель с нативным аудио, например Seedance 1.5 Pro | Действие, слова, голос, совпадение звука с кадром |
| Добавить ветер, шаги и атмосферу к готовому видео | Отдельный проход MMAudio V2 | Уместность эффектов и синхронность событий |
| Оставить оригинальную дорожку при замене объекта | Параметр сохранения звука в выбранном видеоредакторе | Не пропали ли музыка и исходная речь |
| Произнести точный текст поверх ролика | Отдельная генерация речи и монтаж | Произношение, длительность и громкость |
| Заставить персонажа говорить готовой аудиозаписью | Специальный режим lip-sync с проверенной схемой | Лицо, движение губ и тайминг |
Сначала раскадровка: пять секунд в кофейне
Возьмём понятный учебный сюжет: на деревянном столе стоит чашка, рука ставит рядом блюдце, за окном идёт дождь. Камера неподвижна. Нужны тихий фон кофейни и короткий звон керамики. Речи и музыки нет. Такой план помогает разделить видимое действие и ожидаемый звук и не перегружает пятисекундный ролик.
Описание времени — творческое пожелание, а не гарантированный монтажный сценарий. Нейросеть может сместить действие. Поэтому после генерации проверяйте реальные моменты контакта, а не только то, присутствует ли звон вообще. На первом испытании удобнее один план и одно заметное звуковое событие.
| Время | Что видно | Что слышно | Критерий приёмки |
|---|---|---|---|
| 0–1 с | Чашка и пар, дождь за окном | Тихий дождь и ненавязчивый фон помещения | Атмосфера не заглушает главное событие |
| 1–3 с | Рука опускает блюдце на стол | Один короткий звон в момент контакта | Звук не начинается заметно раньше касания |
| 3–5 с | Рука уходит, чашка остаётся в кадре | Снова только спокойная атмосфера | Нет случайных голосов и резкого обрыва |
Сколько стоит видео со звуком
Ниже опубликованные условия fal на 20 октября 2026 года. Рублёвые суммы приблизительны: для наглядности используем коэффициент 110,63 ₽ за $1 с округлением. Это не окончательный тариф Gate. Для конкретного задания фактическая сумма появится после завершения расчёта. Новых платных сравнительных генераций для этой статьи мы не запускали.
| Вариант | Параметры | USD провайдера | Примерно Gate | Когда рассмотреть |
|---|---|---|---|---|
| Seedance 1.5 Pro с аудио | 5 с, 720p | ≈$0,26 | ≈29 ₽ | Новая сцена с аудио в одном запросе |
| Seedance 1.5 Pro без аудио | 5 с, 720p | ≈$0,13 | ≈14 ₽ | Визуальный дубль, звук добавите отдельно |
| Wan 2.6 Flash с аудио | Фото → 5 с, 720p | $0,25 | ≈28 ₽ | Оживить исходное изображение со звуком |
| Wan 2.6 Flash без аудио | Фото → 5 с, 720p | $0,125 | ≈14 ₽ | Немой вариант той же операции |
| H3 Max Turbo, вариант fal | 5 с, 768p, со звуком | $0,13 по акции | ≈14 ₽ | Сравнить ещё один вариант новой сцены |
| MMAudio V2 | Готовое видео, 5 с аудио | $0,005 | ≈0,56 ₽ | Атмосфера и эффекты после создания картинки |
У Seedance опубликован токенный тариф: примерно $0,26 за пять секунд 720p со звуком. У Wan Flash 720p ставка со звуком $0,05 в секунду, без него вдвое меньше. H3 Max Turbo в 768p стоит $0,026 за секунду по акции до 31 октября; затем заявлена ставка $0,04. Длина результата H3 может немного превысить запрошенную, что нужно учитывать при бюджете.
Можно сравнить два способа на одном базовом сценарии: Wan Flash без звука за $0,125 и пятисекундный проход MMAudio за $0,005 дают оценку $0,13 против $0,25 у нативного аудио Wan. Это арифметическая оценка двух заданий, а не доказательство одинакового результата. Совместная генерация может лучше учитывать диалог или сложное взаимодействие звука и движения.
Подготовка: ключ Gate и проверка схемы
Откройте личный кабинет Celestria Gate, создайте API-ключ и убедитесь, что баланс позволяет резерв для задания. Для выполнения команд нужен терминал и cURL. В примерах CELESTRIA_API_KEY — переменная с вашим ключом Gate. Подставьте ключ в своём окружении и храните его на сервере; не вставляйте его в публичную страницу, репозиторий или браузерный код.
Все примеры используют единый /v1/media. Вы задаёте канонический model и явную input.operation, а Gate выбирает совместимого провайдера и переводит настройки. Общие поля находятся непосредственно в input, дополнительные настройки модели — в input.parameters. Разделять клиентскую интеграцию по площадкам не нужно.
Сначала прочитайте схему GET /v1/media/models/schema с model=bytedance/seedance-1-5-pro и operation=text-to-video. Этот вызов не создаёт видео. В GET /v1/media/models выберите карточку по data[].id и проверьте её native_generation: доступность конкретной операции, очередь и причину неготовности. Не запускайте модель с неподтверждённой ценой.
curl --fail-with-body --get \
  'https://api.celestriagate.com/v1/media/models/schema' \
  -H "Authorization: Bearer $CELESTRIA_API_KEY" \
  --data-urlencode 'model=bytedance/seedance-1-5-pro' \
--data-urlencode 'operation=text-to-video'Вариант 1. Новое видео со звуком одним запросом
Создайте обычный текстовый файл seedance-audio.json и вставьте JSON ниже целиком. Оставьте двойные кавычки, запятые и фигурные скобки. В prompt описаны и кадр, и звуковая задача. Параметр generate_audio явно включает аудио, чтобы результат не зависел от того, менялось ли значение по умолчанию.
Это пример структуры запроса, проверенной по официальной схеме, а не опубликованный результат генерации кофейни. Выполнение создаст новый ролик. Для первого собственного запроса можно заменить только описание сцены; остальные значения задают горизонтальное видео 720p длиной пять секунд.
| Поле | Что означает |
|---|---|
| model | Канонический ID bytedance/seedance-1-5-pro |
| operation: text-to-video | Создать видео по описанию |
| input | Общие настройки выбранной операции |
| prompt | Что видно, какое действие происходит и что слышно |
| aspect_ratio: 16:9 | Горизонтальный кадр; для вертикального доступно 9:16 |
| resolution: 720p | Явно выбранное разрешение |
| duration: 5 | Число: пять секунд без кавычек |
| parameters.camera_fixed: true | Настройка модели: просьба сохранить неподвижную камеру |
| generate_audio: true | Создать новую звуковую дорожку |
| parameters.enable_safety_checker: true | Настройка проверки содержимого |
{
  "model": "bytedance/seedance-1-5-pro",
  "input": {
    "operation": "text-to-video",
    "prompt": "A single locked-off shot inside a quiet cafe. A steaming coffee cup stands on a wooden table near a rainy window. A hand slowly places a ceramic saucer next to the cup, then leaves the frame. Soft rain and low cafe room tone. One gentle ceramic clink exactly as the saucer touches the table. No speech, no music, no subtitles.",
    "aspect_ratio": "16:9",
    "resolution": "720p",
    "duration": 5,
    "generate_audio": true,
    "parameters": {
      "camera_fixed": true,
      "enable_safety_checker": true
    }
  }
}
Оцените сцену перед запуском
Сохраните JSON в указанный файл и отправьте его на /v1/media/estimate. Посмотрите предварительную сумму, provider и reason. Это проверка без генерации; окончательный расход появится после выполнения.
curl --fail-with-body -X POST \
  'https://api.celestriagate.com/v1/media/estimate' \
  -H "Authorization: Bearer $CELESTRIA_API_KEY" \
  -H 'Content-Type: application/json' \
  --data-binary @seedance-audio.json
Отправьте JSON и дождитесь результата
Выполняйте команду из папки, где лежит файл. Конструкция @seedance-audio.json означает «прочитать тело запроса из файла», поэтому кавычки внутри JSON не приходится дополнительно экранировать. Idempotency-Key придумайте для этой попытки и сохраните. Для нового варианта сцены нужен новый ключ; при тайм-ауте того же запроса оставьте прежний ключ и прежний JSON.
curl --fail-with-body -X POST \
  'https://api.celestriagate.com/v1/media/generations' \
  -H "Authorization: Bearer $CELESTRIA_API_KEY" \
  -H 'Content-Type: application/json' \
  -H 'Idempotency-Key: cafe-seedance-audio-001' \
  --data-binary @seedance-audio.json
Сохраните ID из ответа
Ответ 202 означает, что Gate создал задание. Найдите строку id и скопируйте её. Это ещё не готовое видео и не окончательная цена.
Проверяйте именно это задание
Запишите полученный ID в GENERATION_ID и выполняйте GET с паузой, например 5–10 секунд. Этот запрос читает состояние и не создаёт второй ролик.
curl --fail-with-body \
  "https://api.celestriagate.com/v1/media/generations/$GENERATION_ID" \
  -H "Authorization: Bearer $CELESTRIA_API_KEY"
Откройте готовый MP4
При completed смотрите result.video.url или подходящий элемент files. Сохраните результат, пока ссылка действует. Не ищите обязательно отдельный MP3: выбранная модель возвращает видеофайл.
Запишите окончательный расход
В billing.cost_rub находится сумма клиента Gate, в billing.upstream_cost_usd — подтверждённый расход провайдера. До расчёта cost_rub может быть null.
queued и pending означают ожидание, in_progress — обработку. awaiting_billing означает, что результат получен и Gate ждёт подтверждения стоимости. Продолжайте читать тот же ID. failed — терминальная ошибка: изучите error.code и error.message перед новой попыткой. Пустая вкладка браузера или обрыв вашего соединения сами по себе не доказывают, что провайдер не начал работу.
Вариант 2. Добавьте звук к уже готовому видео через MMAudio
Этот путь подходит, если ролик уже создан или снят камерой. Понадобится доступная провайдеру HTTPS-ссылка на MP4 и описание звуков. В примере ниже стоит официальный демонстрационный видеофайл fal: его длительность проверена и составляет ровно пять секунд. Он позволяет испытать подключение без собственной загрузки. Музыка в описании — пожелание для этого демо, а не обещание конкретной композиции.
Для своего видео замените video_url и перепишите prompt под реальные действия. Ссылка на страницу с плеером не равна прямой ссылке на файл: сервер должен получить видео без вашего входа в аккаунт. Сначала прочитайте ту же схему /v1/media/models/schema, указав model=mmaudio/mmaudio-v2 и operation=video-to-video; это не запускает аудиогенерацию.
{
  "model": "mmaudio/mmaudio-v2",
  "input": {
    "operation": "video-to-video",
    "video_url": "https://storage.googleapis.com/falserverless/model_tests/video_models/mmaudio_input.mp4",
    "prompt": "Gentle instrumental music matching the mood and motion of the video. Soft natural ambience. No speech.",
    "duration": 5,
    "parameters": {
      "negative_prompt": "speech, distorted audio, clipping",
      "num_steps": 25,
      "cfg_strength": 4.5
    }
  }
}
В общем API duration — число: здесь 5 без кавычек. Дополнительные num_steps, cfg_strength и negative_prompt находятся в parameters; первые два оставлены в стандартных значениях модели. Для MMAudio схема ограничивает длительность 1–30 секундами. Gate сам адаптирует эти настройки под выбранный маршрут, но параметры другой модели всё равно нужно сверять с её схемой.
Запустите аудиопроход и сравните с исходником
Сохраните JSON в mmaudio.json. Команда ниже создаёт отдельное платное задание. Если вы только изучаете варианты и уже получили нужное видео со звуком, выполнять её не требуется. После отправки используйте тот же GET-маршрут проверки, но с новым ID этого задания.
curl --fail-with-body -X POST \
  'https://api.celestriagate.com/v1/media/generations' \
  -H "Authorization: Bearer $CELESTRIA_API_KEY" \
  -H 'Content-Type: application/json' \
  -H 'Idempotency-Key: mmaudio-demo-001' \
  --data-binary @mmaudio.json
При completed модель возвращает result.video.url — новый видеофайл со звуковой дорожкой. Исходный файл по вашей ссылке не переписывается. Прослушайте результат в наушниках и на обычном динамике. Сравните длительность с исходником, начальную и конечную секунды, громкость и моменты заметных действий. Наличие аудиодорожки ещё не означает, что звуковое оформление подходит задаче.
Если готовите цепочку из двух моделей, дождитесь completed первого задания и только затем передавайте его итоговую ссылку во второе. Сохраните оба ID и обе суммы: общая цена состоит из генерации картинки в движении и аудиопрохода. Открывать новую задачу только для проверки статуса не нужно.
Как написать понятный промпт для звука
Опишите место, главный звук, его причину и то, чего быть не должно. Для кофейни: тихий фон помещения, дождь за окном, один звон при касании блюдца, без речи и музыки. Для прогулки: шаги по сухой гравийной дорожке, лёгкий ветер в листве, без голосов. Это конкретнее, чем «сделай красивый профессиональный звук».
Не складывайте в пять секунд несколько диалогов, музыку, громкий транспорт и множество эффектов. Выберите главный слышимый объект. Если требуется реплика, запишите её дословно, обозначьте говорящего и язык. Затем проверьте фактическое произношение: текст в prompt не является гарантией точной дикторской записи.
Для замены персонажа сначала решите судьбу старого звука. Если в исходнике есть нужные шаги и атмосфера, сохранение дорожки может быть уместнее новой генерации. Если исходный голос больше не подходит, отключение или замена аудио должно быть отдельным осознанным шагом. Команда «замени человека» сама по себе не описывает желаемое звуковое сопровождение.
Частые ошибки: что проверить до повторной оплаты
| Ситуация | Следующий шаг |
|---|---|
| 401 или 403 | Проверьте ключ Gate и его права. Ключ другого провайдера здесь не подходит. |
| Ошибка валидации JSON | Проверьте схему, тип duration и допустимые значения resolution. Сохраните двойные кавычки и запятые. |
| Видео по ссылке не скачивается | Проверьте прямую HTTPS-ссылку без авторизации, тип файла и срок её действия. |
| Недостаточно средств для резерва | Проверьте доступный баланс: предварительный резерв может быть больше цены короткого ролика. |
| Запрос оборвался после POST | Сначала найдите созданное задание. Для повтора используйте тот же JSON и Idempotency-Key. |
| awaiting_billing долго не меняется | Продолжайте проверять существующий ID и передайте его поддержке. Не создавайте дубль. |
| completed, но аудио не слышно | Проверьте громкость плеера, сам файл и generate_audio в сохранённом запросе. Новая попытка — отдельное решение. |
| Эффекты есть, но слова неразборчивы | Для точной речи сравните нативный диалог, отдельную генерацию голоса и специализированный lip-sync. |
Оценка, резерв и списание — разные суммы. estimated_cost_rub помогает планировать, reserved_rub временно удерживает средства, cost_rub показывает окончательный расход. При ошибке сверяйте error и billing конкретного задания. Успешный ролик с неудачным художественным результатом при этом может быть оплаченной генерацией.
Для проверки интеграции сохраните модель, JSON без секрета, ID задания, выбранный маршрут, итоговую ссылку и billing. Так можно воспроизвести настройки и понять цену удачного дубля. Если нужны полные примеры Python и JavaScript или замена предмета по фото, переходите к следующим инструкциям.
Частые вопросы
Можно ли получить видео и звук одним API-запросом?
Да, у моделей с нативным аудио. В примере Seedance 1.5 Pro используется generate_audio: true. Структура описана по официальной схеме; окончательное качество конкретной сцены нужно проверять после генерации.
Как добавить звук к готовому немому MP4?
Передайте прямую HTTPS-ссылку на видео и описание звука в /v1/media/generations: model=mmaudio/mmaudio-v2, input.operation=video-to-video. duration задаётся числом. Результат приходит как новый видеофайл, а не обязательно отдельная аудиодорожка.
Сколько стоит озвучить пять секунд видео через MMAudio?
Опубликованный тариф fal — $0,001 за секунду, то есть $0,005 за пять секунд. В статье это примерно 0,56 ₽ по расчётному коэффициенту. Окончательное списание Gate появится в billing.cost_rub завершённого задания.
MMAudio гарантирует точную речь и совпадение губ?
Мы этого не утверждаем. Отдельный аудиопроход рассматриваем прежде всего для атмосферы и эффектов. Для заданной реплики нужны проверка произношения и подходящий речевой или lip-sync-сценарий.
Нужен ли отдельный ключ поставщика моделей?
Для запросов нужен только ключ Celestria Gate в Authorization: Bearer. Вы используете /v1/media и каноническую модель; выбор совместимого провайдера выполняет Gate. При одном маршруте или неполных ценах ответ не объявляет доказанный минимум.
Что делать, если статус awaiting_billing?
Проверять тот же ID. Видео уже обработано, но подтверждённая стоимость ещё ожидается. Повторное создание с новым ключом не ускорит расчёт и может запустить ещё одну оплачиваемую генерацию.